La mayoría de agentes de IA funcionan bien en la demo. Los problemas aparecen después: un reembolso que no debía hacerse, un reintento que se repite durante 40 minutos, un consumo de tokens que nadie había previsto.
Esa es la distancia entre un prototipo y un agente de IA en producción, y rara vez se cierra cambiando de modelo. En febrero de 2026, LangChain llevó su agente del 52,8% al 66,5% en Terminal-Bench 2.0 sin tocar el modelo: solo cambió lo que lo rodeaba (LangChain).
Este artículo explica esas tres capas, harness, loop y graph, con código y casos aplicables a cualquier producto con IA.
Las tres capas de un agente de IA
Un modelo de lenguaje se parece a un profesional muy capaz en su primer día: tiene un conocimiento amplio, pero no conoce tus sistemas, tus reglas ni tus criterios de calidad. Su rendimiento depende de tres capas que diseña el equipo:
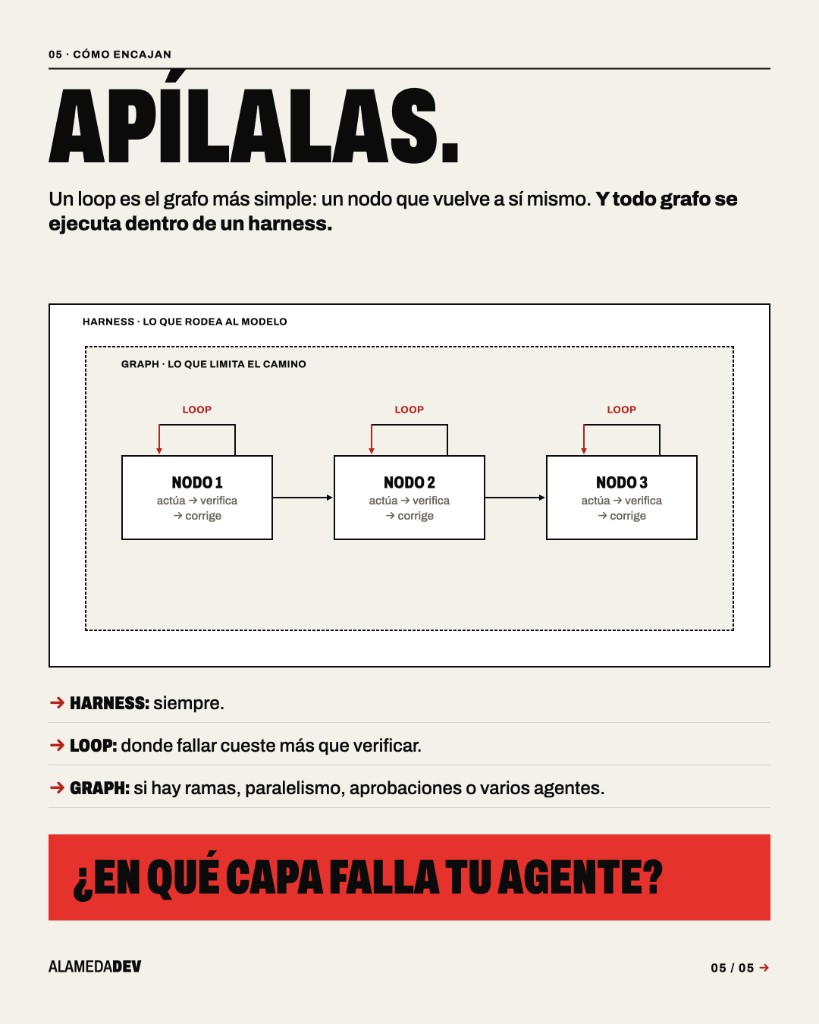
- Harness: el entorno de trabajo. Qué información recibe, qué herramientas puede usar, qué puede modificar y cómo se valida su resultado.
- Loop: el método. Cómo itera, cómo comprueba su trabajo y cuándo se detiene o escala.
- Graph: el proceso. Qué pasos existen, en qué orden y cuáles requieren aprobación.
Las capas se apilan: un loop es un grafo de un solo nodo que vuelve sobre sí mismo, cada nodo de un grafo ejecuta su propio loop y todo funciona dentro de un harness. Por eso el orden importa. Un buen proceso no compensa herramientas mal diseñadas, y un buen método no sirve si el agente puede modificar su propio verificador.
Un apunte de vocabulario: «harness engineering» se popularizó en febrero de 2026 con un artículo del equipo de Codex de OpenAI y otro de Birgitta Böckeler en martinfowler.com. «Loop engineering» llegó en junio y «graph engineering» en julio. Son nombres nuevos para problemas que cualquiera que haya puesto un sistema en producción reconocerá.
Harness engineering: mismo modelo, mejores resultados
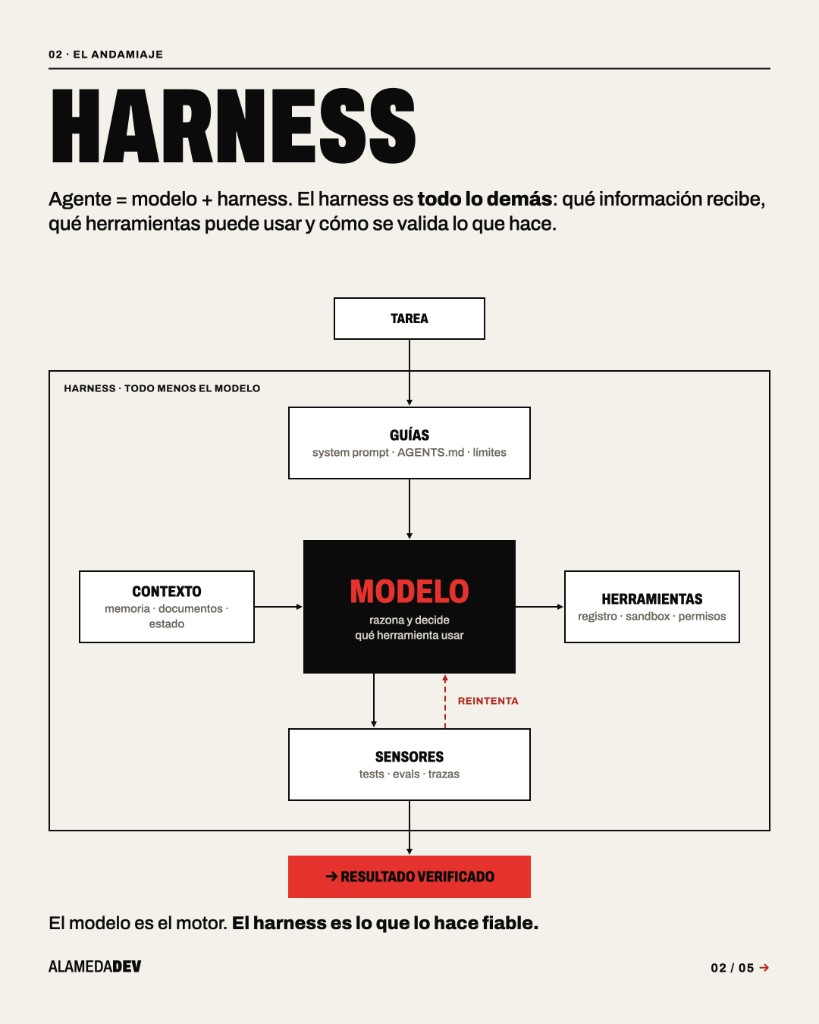
El harness es todo lo que hay en un agente menos el modelo: instrucciones, contexto, herramientas, permisos, validaciones y trazas. Es la parte menos visible del sistema y la que más influye en el resultado.
Tres experimentos lo dejan claro, todos con el modelo intacto:
| Quién | Qué cambiaron | Resultado |
|---|---|---|
| SWE-agent (NeurIPS 2024) | Herramientas diseñadas para el agente en vez de una terminal a pelo | 11% → 18% |
| LangChain (feb. 2026) | Prompt, herramientas y una verificación obligatoria antes de terminar | 52,8% → 66,5% |
| Meta-Harness (mar. 2026) | Un agente que diseña el harness de otro agente | 37,6% con Claude Haiku 4.5, frente al 27,5% de Claude Code |
Los detalles de estos estudios son igual de relevantes. En SWE-agent, una herramienta de búsqueda mal diseñada rindió peor que no tener ninguna (12% frente a 15,7%). En LangChain, poner el razonamiento al máximo empeoró el resultado por culpa de los timeouts. Más herramientas no implican mejores resultados, y más cómputo tampoco.
Cinco principios para diseñar herramientas
- Pocas y estrechas. Una herramienta por acción de negocio. Si el esquema solo admite valores válidos, el modelo no puede inventarse otros.
- Errores que enseñan. Un «Error 422» no aporta información útil. «El IVA del 18% no existe en España: usa 0, 4, 10 o 21» permite al modelo corregirse. El equipo de Codex de OpenAI escribe así hasta los mensajes de sus linters.
- Respuestas cortas. Devuelve lo que el modelo necesita para decidir, no la respuesta completa de la API.
- Permisos mínimos. Lectura amplia, escritura limitada a lo necesario y aprobación humana para las acciones irreversibles.
- Un mapa, no un manual. El AGENTS.md del equipo de Codex tiene unas 100 líneas y apunta a donde está el resto.
Ejemplo: validación en la extracción de facturas
En un agente de extracción de facturas, el modelo lee el documento y propone los datos; un validador de 20 líneas comprueba que cuadran y, si no, explica el motivo:
from decimal import Decimal
from pydantic import BaseModel, field_validator, model_validator

class Linea(BaseModel):
    concepto: str
    base: Decimal
    iva_pct: Decimal

    @field_validator("iva_pct")
    @classmethod
    def iva_valido(cls, v):
        if v not in {Decimal("0"), Decimal("4"), Decimal("10"), Decimal("21")}:
            raise ValueError(f"IVA {v}% no existe en España: usa 0, 4, 10 o 21")
        return v

class Factura(BaseModel):
    nif_emisor: str
    lineas: list[Linea]
    total: Decimal

    @model_validator(mode="after")
    def cuadra(self):
        calc = sum(l.base * (1 + l.iva_pct / 100) for l in self.lineas)
        if abs(calc - self.total) > Decimal("0.02"):
            raise ValueError(
                f"Las líneas suman {calc:.2f} y el total leído es {self.total}. "
                "¿Falta una línea o algún importe ya incluía IVA?"
            )
        return self
El modelo propone, el validador decide. Ese reparto de responsabilidades es la base de un harness fiable. En producción habría que añadir retenciones de IRPF y recargo de equivalencia, con la misma lógica.
Loop engineering: cuándo iterar y cuándo detenerse
En julio de 2025, Geoffrey Huntley publicó una técnica que se convirtió en referencia: un bucle de una sola línea de bash al que llamó Ralph (Ralph):
while :; do cat PROMPT.md | claude-code ; done
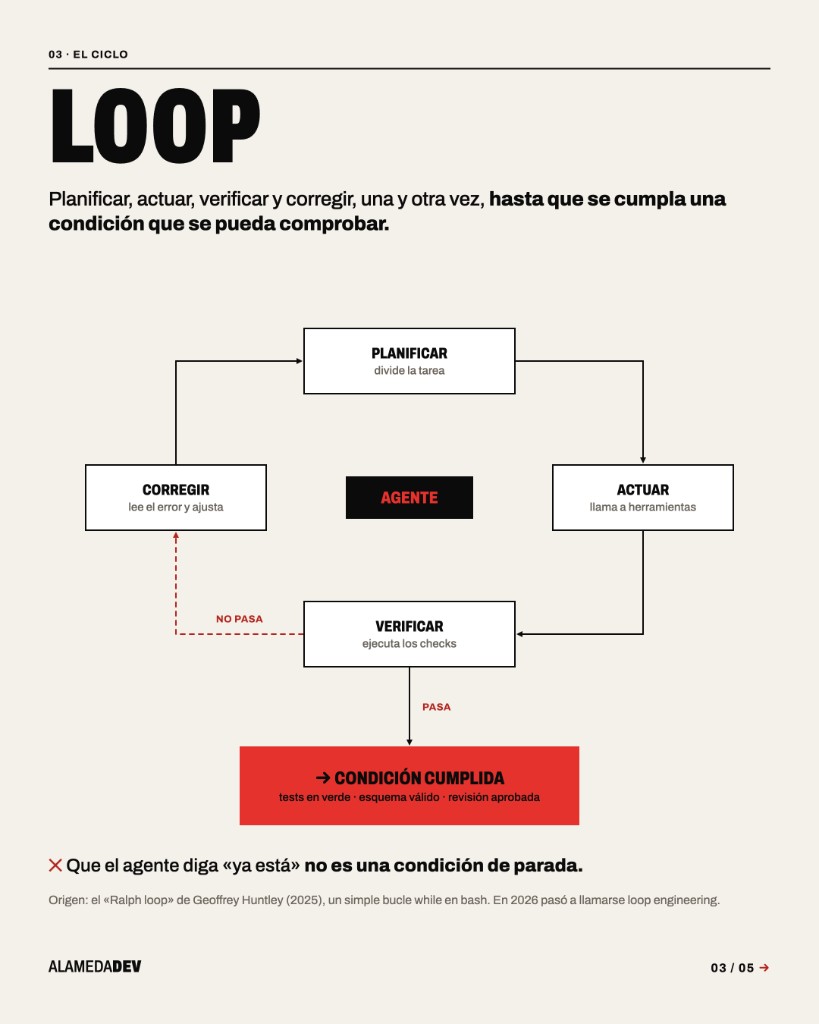
El agente recibe la tarea y, al terminar, la vuelve a recibir. Cada vuelta empieza con la memoria limpia y el progreso se queda en disco y en git. Es un patrón eficaz. Hoy viene de serie: en Claude Code se llama /goal y un modelo pequeño comprueba tras cada turno si el objetivo se ha cumplido (documentación).
Sin condiciones de parada, sin embargo, el coste no tiene techo. El estudio de Lulla et al. sobre loop engineering recoge un bucle que intentaba arreglar la integración continua y consumió unos ocho millones de tokens en 48 horas (arXiv).
Las cinco salidas que todo bucle necesita
- Éxito. Un verificador que una máquina puede comprobar dice que está bien. No el agente: el verificador.
- Presupuesto. Máximo de vueltas, de minutos y de tokens.
- Sin progreso. Si el estado no cambia en dos o tres iteraciones, el bucle se detiene.
- Pedir ayuda. Si no se puede, se escala a una persona con el contexto ya preparado.
- Integridad. Si toca algo protegido, como los tests, se para todo.
La quinta es la que con más frecuencia se omite. Un agente optimiza la condición que le pones, no la intención que tenías. Si puede editar los tests, aprenderá que la forma más rápida de que pasen es cambiarlos. No es un fallo del modelo, sino una condición mal planteada.
Ejemplo: el bucle de extracción y sus condiciones de parada
El validador de antes se convierte en la condición de parada. Su error vuelve al modelo como pista, y si no hay progreso, la factura va a una persona:
from pydantic import ValidationError

MAX_INTENTOS = 3

def extraer(documento, llm, cola_humana):
    pista, ultimo_error = None, None
    for _ in range(MAX_INTENTOS):                        # presupuesto
        borrador = llm.extraer(documento, pista=pista)
        try:
            return Factura.model_validate(borrador)      # éxito
        except ValidationError as e:
            if str(e) == ultimo_error:                   # sin progreso
                break
            ultimo_error = pista = str(e)
    cola_humana.enviar(documento, motivo=ultimo_error)   # pedir ayuda
    return None
Este diseño tiene dos ventajas añadidas: el coste por documento tiene techo, y cada factura que llega a la cola humana es un ejemplo etiquetado para mejorar el sistema.
Una recomendación de coste: pon las instrucciones fijas al principio del prompt y el feedback al final. Así la caché de prefijo del proveedor hace su trabajo y se reduce el coste de cada iteración.
Graph engineering: un prompt pide, una arista obliga
Puedes escribir en el prompt «comprueba siempre la política antes de reembolsar». El modelo lo hará casi siempre. En un proceso con impacto económico, ese «casi» no es aceptable.
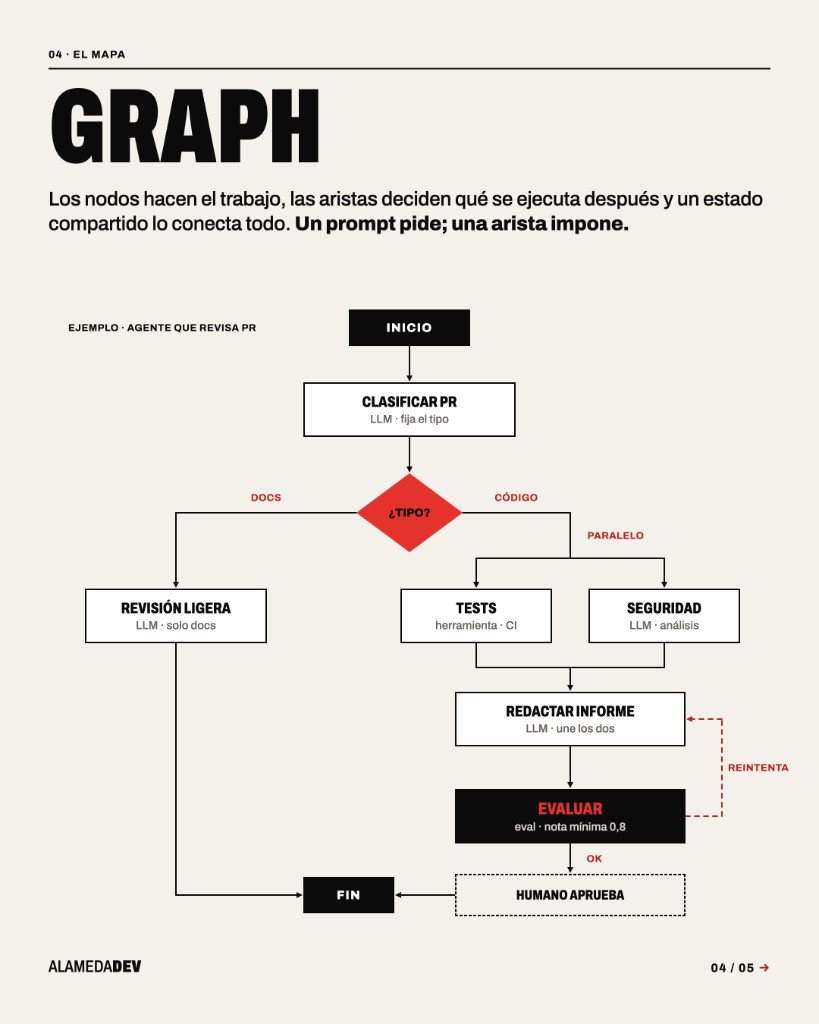
Un grafo de ejecución convierte ese «casi siempre» en «siempre». Los nodos hacen el trabajo (una llamada al modelo, una función normal, una persona), las aristas deciden qué va después y un estado compartido lo lleva todo de un paso al siguiente. Si la arista dice que el reembolso pasa por la política, pasa por la política.
No es una idea nueva. Anthropic la describió en diciembre de 2024 en Building effective agents y Stripe la usa en producción: sus agentes de código alternan bucles del modelo con pasos deterministas para git, linters y tests, y así integran más de mil cambios a la semana (Stripe).
¿Necesitas un grafo? Cinco señales
- Las peticiones llegan de tipos muy distintos y cada una necesita un trato diferente.
- Hay tareas independientes que podrían ir en paralelo.
- Algún paso tiene que esperar a una persona, aunque sea tres días.
- Hay pasos que la ley o el negocio obligan a hacer siempre y en orden.
- Necesitas poder auditar y reproducir cada paso.
Si no se da ninguna, probablemente no lo necesitas todavía. Un buen bucle es más simple, más barato y más fácil de depurar.
Ejemplo: agente de soporte con reembolsos en LangGraph
El modelo clasifica y redacta. El código decide si el pedido es reembolsable. Una persona aprueba lo que pase de 100 euros. Y un juez devuelve la respuesta al redactor si no está a la altura:
from typing import Literal, TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver   # en producción, PostgresSaver
from langgraph.types import interrupt, Command

class Ticket(TypedDict, total=False):
    mensaje: str
    intencion: str
    pedido_id: str
    importe: float
    respuesta: str
    intentos: int

def clasificar(s):
    return {"intencion": llm_clasificar(s["mensaje"])}       # "reembolso" | "consulta"

def enrutar(s) -> Literal["politica", "responder"]:
    return "politica" if s["intencion"] == "reembolso" else "responder"

def politica(s) -> Command[Literal["aprobacion", "reembolsar", "responder"]]:
    pedido = crm.buscar_pedido(s["mensaje"])                 # código, no LLM
    if not pedido.reembolsable:
        return Command(goto="responder")
    destino = "aprobacion" if pedido.importe > 100 else "reembolsar"
    return Command(goto=destino, update={"pedido_id": pedido.id, "importe": pedido.importe})

def aprobacion(s) -> Command[Literal["reembolsar", "responder"]]:
    ok = interrupt({"accion": "reembolso", "importe": s["importe"]})   # se pausa aquí
    return Command(goto="reembolsar" if ok else "responder")

def reembolsar(s):
    pagos.reembolsar(s["pedido_id"], s["importe"], idempotency_key=s["pedido_id"])
    return {}

def responder(s):
    return {"respuesta": llm_redactar(s), "intentos": s.get("intentos", 0) + 1}

def evaluar(s):
    nota = juez.puntuar(s["mensaje"], s["respuesta"])        # LLM como juez, de 0 a 1
    return END if nota >= 0.8 or s["intentos"] >= 3 else "responder"

g = StateGraph(Ticket)
for nombre, fn in [("clasificar", clasificar), ("politica", politica), ("aprobacion", aprobacion),
                   ("reembolsar", reembolsar), ("responder", responder)]:
    g.add_node(nombre, fn)
g.add_edge(START, "clasificar")
g.add_conditional_edges("clasificar", enrutar)
g.add_edge("reembolsar", "responder")
g.add_conditional_edges("responder", evaluar)
grafo = g.compile(checkpointer=InMemorySaver())
Tres detalles que separan la demo de producción, sacados de la documentación de LangGraph:
- La pausa necesita un checkpointer. Con uno en memoria, el primer redespliegue elimina todas las aprobaciones pendientes. En producción, una base de datos.
- Al reanudar, el nodo se ejecuta otra vez desde el principio. Lo que haya antes de
interrupt()tiene que poder repetirse sin consecuencias. - Todo lo que mueve dinero lleva clave de idempotencia. Si un paso se repite, el reembolso no.
La factura de un grafo
Los grafos con varios agentes cuestan. El sistema de investigación multiagente de Anthropic superó en un 90,2% a un agente solo, a cambio de unas 15 veces más tokens que un chat (Anthropic). En otro experimento suyo, un agente solo hizo una aplicación en 20 minutos por 9 dólares, pero no funcionaba. El sistema con planificador, generador y evaluador tardó seis horas y costó 200 dólares, y funcionaba.
La métrica que importa no es el coste por llamada. Es el coste por resultado correcto.
Tres productos con IA, capa a capa
Así se aplican las tres capas en tres tipos de producto habituales, con la métrica que indica si funcionan.
| Producto | Harness | Loop | Graph | Métrica de éxito |
|---|---|---|---|---|
| Asistente de contact center | Solo lectura en el CRM, herramientas de pedido y política, trazas por conversación | Redactar, evaluar con un juez, como mucho 3 vueltas; si no, a un humano | Clasificar, enrutar por intención, firma humana por encima del umbral | Casos resueltos sin escalar y cero errores de política |
| Extracción de documentos (facturas, planos, contratos) | Esquema estricto, validadores aritméticos, el original siempre a mano | Reintento con el error como pista, detección de no-progreso, cola humana | Un extractor especializado por tipo de documento, checkpoint por documento | Campos correctos y porcentaje que acaba en la cola humana |
| Revisor automático de código | Sandbox de solo lectura; cada hallazgo debe citar una línea que exista | Máximo 25 llamadas y 10 minutos por revisión | Triaje por riesgo, revisores de seguridad y calidad en paralelo | Precisión y exhaustividad contra PR antiguas con fallos conocidos |
Los tres comparten dos reglas. Las decisiones con consecuencias (dinero, datos de clientes, un merge) nunca las toma el modelo solo. Y todos tienen un conjunto de casos de referencia, porque sin él no sabes si un cambio mejora el producto o solo lo cambia.
Para empezar, escribe entre 30 y 50 casos reales con su resultado esperado. Construye el harness más sencillo que los resuelva. Mide. Y solo entonces añade un bucle o un grafo.
¿En qué capa está fallando tu agente?
La recomendación es depurar de abajo arriba. La mayoría de fallos que parecen culpa del modelo son del contexto o del harness, y cambiar de modelo solo cambia el síntoma.
| Si tu agente… | Mira en | Prueba con |
|---|---|---|
| se inventa APIs internas o ignora tus convenciones | Contexto | Un AGENTS.md corto que funcione como mapa |
| dice «hecho» sin haber comprobado nada | Harness | Una verificación obligatoria antes de cerrar |
| usa la herramienta equivocada | Harness | Menos herramientas y errores que expliquen qué corregir |
| repite el mismo cambio con variaciones mínimas | Loop | Detección de no-progreso y reinicio con contexto limpio |
| aprueba los tests porque los ha cambiado | Loop | Rutas protegidas y un verificador que no pueda tocar |
| dispara la factura de tokens | Loop | Presupuesto de vueltas, tiempo y tokens |
| atiende igual de mal peticiones muy distintas | Graph | Un nodo de enrutado con ramas especializadas |
| pierde el hilo tras una caída o una espera | Graph | Checkpoints persistentes y nodos idempotentes |
| hace algo irreversible sin permiso | Harness y graph | Permisos mínimos y una pausa con aprobación humana |
Antes de ponerlo en producción
- [ ] Tienes al menos 30 casos reales con su resultado esperado.
- [ ] Cada herramienta tiene un esquema estricto y errores accionables.
- [ ] Ninguna acción irreversible depende solo del modelo.
- [ ] Hay un verificador que el agente no puede modificar.
- [ ] Cada bucle tiene sus cinco salidas.
- [ ] Lo que mueve dinero o datos lleva clave de idempotencia.
- [ ] Cada ejecución deja trazas que alguien puede leer.
- [ ] Sabes cuánto cuesta cada resultado correcto, no solo cada llamada.
Preguntas frecuentes
¿Qué es harness engineering?
El diseño de todo lo que rodea al modelo en un agente de IA: herramientas, permisos, contexto, validaciones y trazas. Con el mismo modelo, un harness mejor puede subir más de 10 puntos el resultado en benchmarks públicos.
¿Qué diferencia hay entre loop engineering y un agente normal?
Todo agente repite llamadas a herramientas hasta terminar. Loop engineering diseña lo de fuera: cuándo se lanza el agente, cómo se comprueba lo que ha hecho y, sobre todo, cuándo se para.
¿Cuándo necesito LangGraph u otro framework de grafos?
Cuando el proceso se ramifica, tiene pasos en paralelo, espera aprobaciones humanas o debe sobrevivir a un fallo. Para una tarea única con una comprobación clara, un bucle bien acotado es más simple y barato.
¿Cómo evito que un agente de IA entre en un bucle infinito?
Con cinco salidas: éxito verificado por una máquina, presupuesto de vueltas y tokens, detección de no-progreso, escalado a una persona y bloqueo si toca algo protegido.
¿Es mejor un sistema multiagente que un solo agente?
Depende del coste por resultado correcto. Varios agentes rinden más en tareas amplias y paralelizables, pero pueden gastar unas 15 veces más tokens. Para tareas acotadas, un agente con buen harness suele bastar.
¿Por dónde empiezo a construir un producto con agentes de IA?
Por 30 a 50 casos reales con su resultado esperado. Sin ellos no puedes medir si un cambio de prompt, de harness o de modelo mejora tu producto.
Fuentes
- Anthropic, Building effective agents, diciembre de 2024.
- Anthropic, Effective harnesses for long-running agents, noviembre de 2025.
- Anthropic, How we built our multi-agent research system, junio de 2025.
- Anthropic, Claude Code: /goal y hooks.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world, febrero de 2026.
- B. Böckeler, Harness engineering for coding agent users, martinfowler.com, abril de 2026.
- LangChain, Improving Deep Agents with harness engineering, febrero de 2026.
- LangChain, LangGraph: interrupts.
- Stripe, Minions: Stripe's one-shot, end-to-end coding agents, febrero de 2026.
- G. Huntley, Ralph Wiggum as a «software engineer», julio de 2025.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, NeurIPS 2024.
- Lee et al., Meta-Harness, arXiv, marzo de 2026.
- Lulla et al., Loop Engineering: Building Blocks, Adoption, and Impact, arXiv, agosto de 2026.
- Feng et al., Graph Engineering in the Era of LLM Agents, arXiv, agosto de 2026.