La majoria d'agents d'IA funcionen bé a la demo. Els problemes apareixen després: un reemborsament que no s'havia de fer, un reintent que es repeteix durant 40 minuts, un consum de tokens que ningú havia previst.
Aquesta és la distància entre un prototip i un agent d'IA en producció, i rarament es tanca canviant de model. El febrer de 2026, LangChain va portar el seu agent del 52,8% al 66,5% a Terminal-Bench 2.0 sense tocar el model: només va canviar el que l'envoltava (LangChain).
Aquest article explica aquestes tres capes, harness, loop i graph, amb codi i casos aplicables a qualsevol producte amb IA.
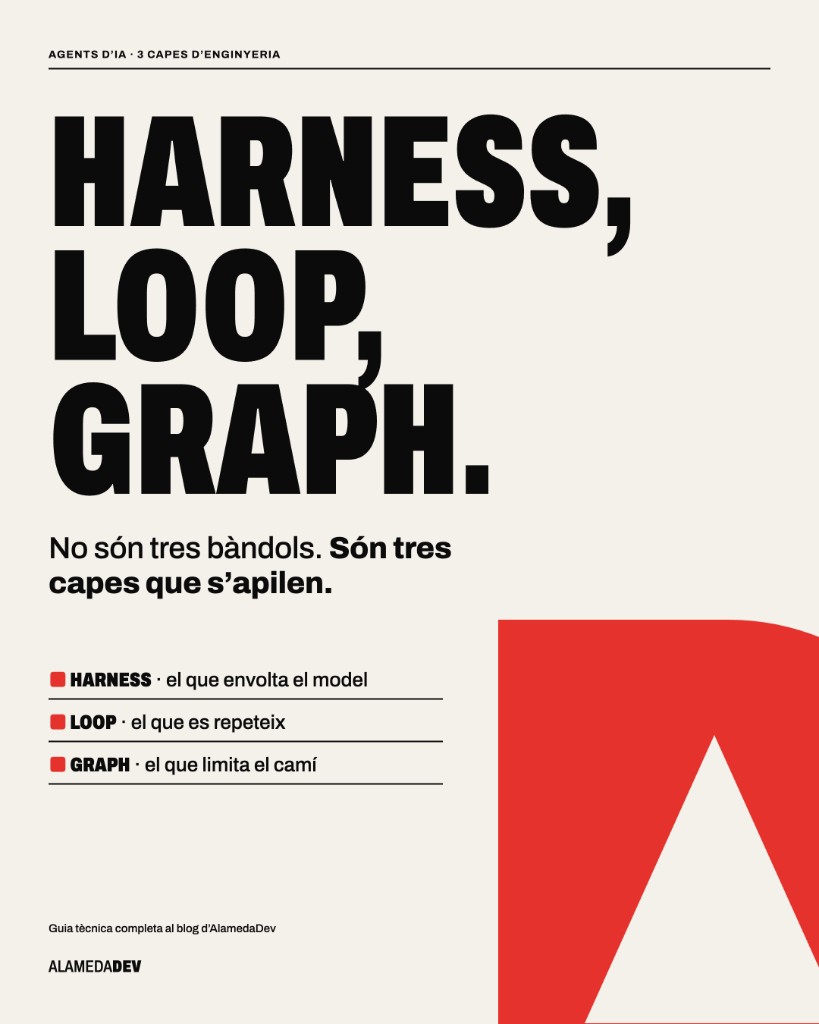
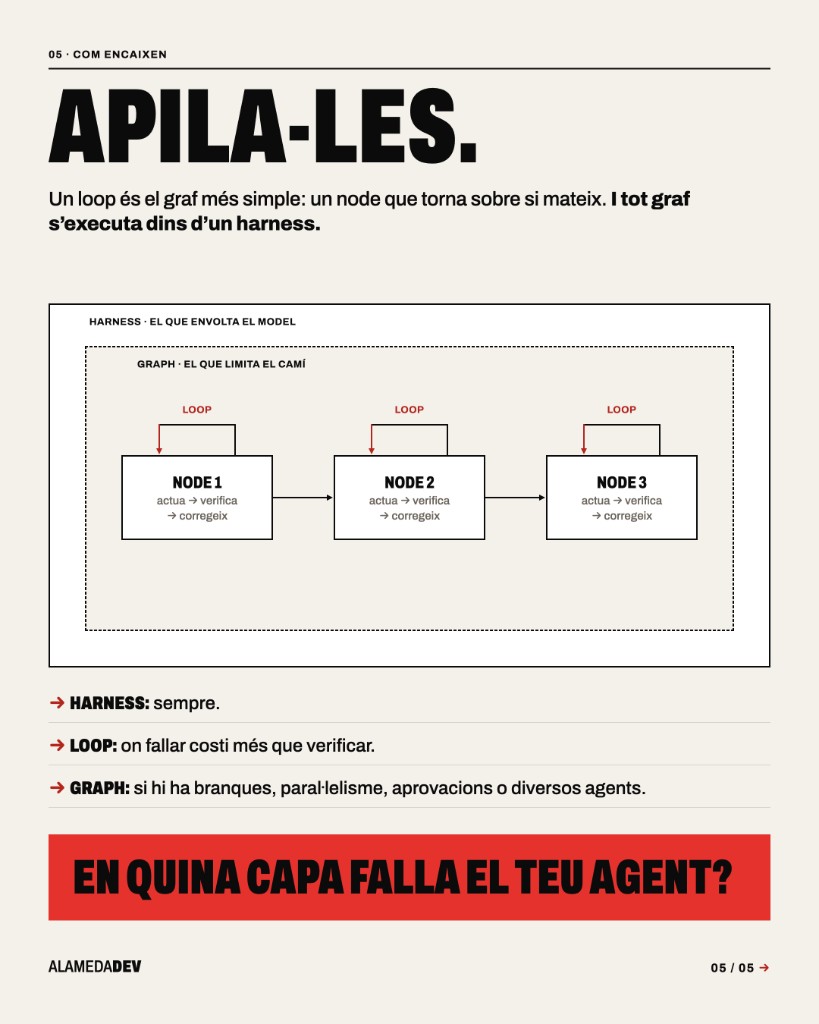
Les tres capes d'un agent d'IA
Un model de llenguatge s'assembla a un professional molt capaç el seu primer dia: té un coneixement ampli, però no coneix els teus sistemes, les teves regles ni els teus criteris de qualitat. El seu rendiment depèn de tres capes que dissenya l'equip:
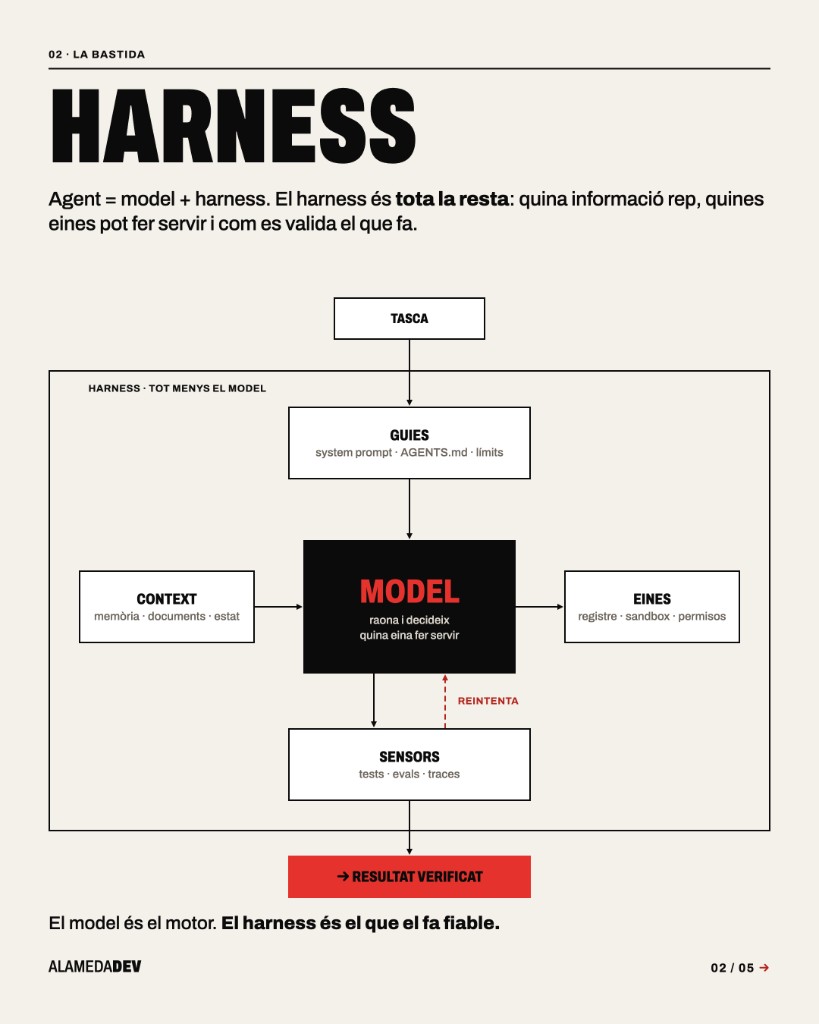
- Harness: l'entorn de treball. Quina informació rep, quines eines pot fer servir, què pot modificar i com es valida el resultat.
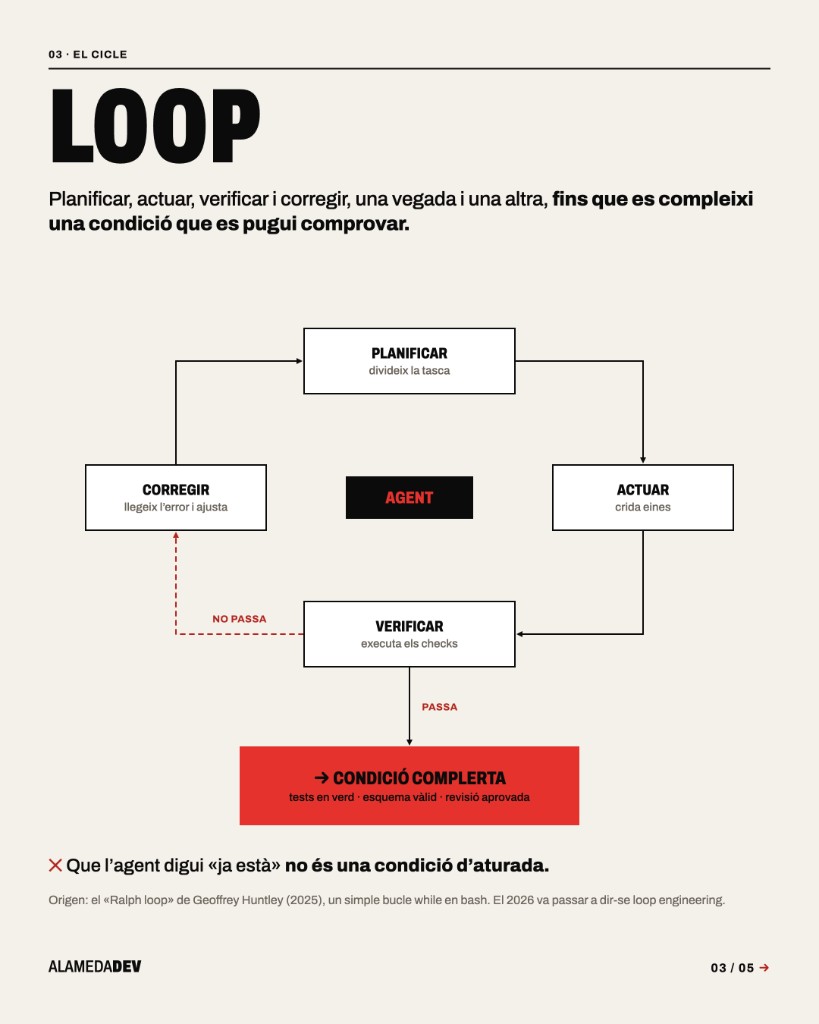
- Loop: el mètode. Com itera, com comprova la seva feina i quan s'atura o escala.
- Graph: el procés. Quins passos hi ha, en quin ordre i quins requereixen aprovació.
Les capes s'apilen: un loop és un graf d'un sol node que torna sobre si mateix, cada node d'un graf executa el seu propi loop i tot funciona dins d'un harness. Per això l'ordre importa. Un bon procés no compensa eines mal dissenyades, i un bon mètode no serveix si l'agent pot modificar el seu propi verificador.
Una nota de vocabulari: «harness engineering» es va popularitzar el febrer de 2026 amb un article de l'equip de Codex d'OpenAI i un altre de Birgitta Böckeler a martinfowler.com. «Loop engineering» va arribar el juny i «graph engineering» el juliol. Són noms nous per a problemes que qualsevol que hagi posat un sistema en producció reconeixerà.
Harness engineering: mateix model, millors resultats
El harness és tot el que hi ha en un agent excepte el model: instruccions, context, eines, permisos, validacions i traces. És la part menys visible del sistema i la que més influeix en el resultat.
Tres experiments ho deixen clar, tots amb el model intacte:
| Qui | Què van canviar | Resultat |
|---|---|---|
| SWE-agent (NeurIPS 2024) | Eines dissenyades per a l'agent en lloc d'un terminal sense més | 11% → 18% |
| LangChain (febr. 2026) | Prompt, eines i una verificació obligatòria abans d'acabar | 52,8% → 66,5% |
| Meta-Harness (març 2026) | Un agent que dissenya el harness d'un altre agent | 37,6% amb Claude Haiku 4.5, davant el 27,5% de Claude Code |
Els detalls d'aquests estudis són igual de rellevants. A SWE-agent, una eina de cerca mal dissenyada va rendir pitjor que no tenir-ne cap (12% davant 15,7%). A LangChain, posar el raonament al màxim va empitjorar el resultat per culpa dels timeouts. Més eines no impliquen millors resultats, i més còmput tampoc.
Cinc principis per dissenyar eines
- Poques i estretes. Una eina per acció de negoci. Si l'esquema només admet valors vàlids, el model no en pot inventar d'altres.
- Errors que ensenyen. Un «Error 422» no aporta informació útil. «L'IVA del 18% no existeix a Espanya: fes servir 0, 4, 10 o 21» permet al model corregir-se. L'equip de Codex d'OpenAI escriu així fins i tot els missatges dels seus linters.
- Respostes curtes. Retorna el que el model necessita per decidir, no la resposta completa de l'API.
- Permisos mínims. Lectura àmplia, escriptura limitada al necessari i aprovació humana per a les accions irreversibles.
- Un mapa, no un manual. L'AGENTS.md de l'equip de Codex té unes 100 línies i apunta on és la resta.
Exemple: validació en l'extracció de factures
En un agent d'extracció de factures, el model llegeix el document i proposa les dades; un validador de 20 línies comprova que quadren i, si no, n'explica el motiu:
from decimal import Decimal
from pydantic import BaseModel, field_validator, model_validator

class Linia(BaseModel):
    concepte: str
    base: Decimal
    iva_pct: Decimal

    @field_validator("iva_pct")
    @classmethod
    def iva_valid(cls, v):
        if v not in {Decimal("0"), Decimal("4"), Decimal("10"), Decimal("21")}:
            raise ValueError(f"L'IVA {v}% no existeix a Espanya: fes servir 0, 4, 10 o 21")
        return v

class Factura(BaseModel):
    nif_emissor: str
    linies: list[Linia]
    total: Decimal

    @model_validator(mode="after")
    def quadra(self):
        calc = sum(l.base * (1 + l.iva_pct / 100) for l in self.linies)
        if abs(calc - self.total) > Decimal("0.02"):
            raise ValueError(
                f"Les línies sumen {calc:.2f} i el total llegit és {self.total}. "
                "Falta una línia o algun import ja incloïa l'IVA?"
            )
        return self
El model proposa, el validador decideix. Aquest repartiment de responsabilitats és la base d'un harness fiable. En producció caldria afegir les retencions d'IRPF i el recàrrec d'equivalència, amb la mateixa lògica.
Loop engineering: quan iterar i quan aturar-se
El juliol de 2025, Geoffrey Huntley va publicar una tècnica que es va convertir en referència: un bucle d'una sola línia de bash que va anomenar Ralph:
while :; do cat PROMPT.md | claude-code ; done
L'agent rep la tasca i, en acabar, la torna a rebre. Cada volta comença amb la memòria neta i el progrés queda al disc i a git. És un patró eficaç. Avui ja ve de sèrie: a Claude Code es diu /goal i un model petit comprova després de cada torn si l'objectiu s'ha complert (documentació).
Sense condicions d'aturada, però, el cost no té sostre. L'estudi de Lulla et al. sobre loop engineering recull un bucle que intentava arreglar la integració contínua i va consumir uns vuit milions de tokens en 48 hores (arXiv).
Les cinc sortides que necessita tot bucle
- Èxit. Un verificador que una màquina pot comprovar diu que està bé. No l'agent: el verificador.
- Pressupost. Màxim de voltes, de minuts i de tokens.
- Sense progrés. Si l'estat no canvia en dues o tres iteracions, el bucle s'atura.
- Demanar ajuda. Si no es pot, s'escala a una persona amb el context ja preparat.
- Integritat. Si toca alguna cosa protegida, com els tests, s'atura tot.
La cinquena és la que s'omet més sovint. Un agent optimitza la condició que li poses, no la intenció que tenies. Si pot editar els tests, aprendrà que la manera més ràpida que passin és canviar-los. No és una fallada del model, sinó una condició mal plantejada.
Exemple: el bucle d'extracció i les seves condicions d'aturada
El validador d'abans es converteix en la condició d'aturada. El seu error torna al model com a pista, i si no hi ha progrés, la factura va a una persona:
from pydantic import ValidationError

MAX_INTENTS = 3

def extreure(document, llm, cua_humana):
    pista, ultim_error = None, None
    for _ in range(MAX_INTENTS):                         # pressupost
        esborrany = llm.extreure(document, pista=pista)
        try:
            return Factura.model_validate(esborrany)     # èxit
        except ValidationError as e:
            if str(e) == ultim_error:                    # sense progrés
                break
            ultim_error = pista = str(e)
    cua_humana.enviar(document, motiu=ultim_error)       # demanar ajuda
    return None
Aquest disseny té dos avantatges afegits: el cost per document té sostre, i cada factura que arriba a la cua humana és un exemple etiquetat per millorar el sistema.
Una recomanació de cost: posa les instruccions fixes al principi del prompt i el feedback al final. Així la memòria cau de prefix del proveïdor fa la seva feina i es redueix el cost de cada iteració.
Graph engineering: un prompt demana, una aresta obliga
Pots escriure al prompt «comprova sempre la política abans de reemborsar». El model ho farà gairebé sempre. En un procés amb impacte econòmic, aquest «gairebé» no és acceptable.
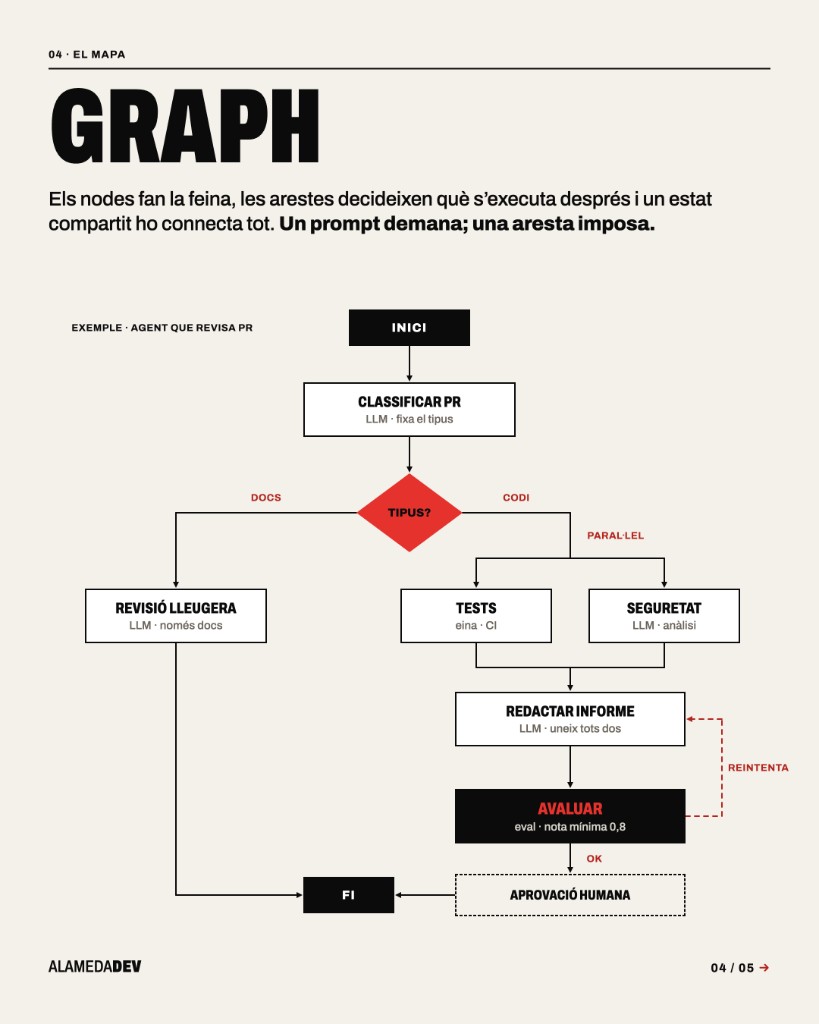
Un graf d'execució converteix aquest «gairebé sempre» en «sempre». Els nodes fan la feina (una crida al model, una funció normal, una persona), les arestes decideixen què va després i un estat compartit ho porta tot d'un pas al següent. Si l'aresta diu que el reemborsament passa per la política, passa per la política.
No és una idea nova. Anthropic la va descriure el desembre de 2024 a Building effective agents i Stripe la fa servir en producció: els seus agents de codi alternen bucles del model amb passos deterministes per a git, linters i tests, i així integren més de mil canvis a la setmana (Stripe).
Necessites un graf? Cinc senyals
- Les peticions arriben de tipus molt diferents i cadascuna necessita un tracte diferent.
- Hi ha tasques independents que podrien anar en paral·lel.
- Algun pas ha d'esperar una persona, encara que siguin tres dies.
- Hi ha passos que la llei o el negoci obliguen a fer sempre i en ordre.
- Necessites poder auditar i reproduir cada pas.
Si no se'n dóna cap, probablement encara no el necessites. Un bon bucle és més simple, més barat i més fàcil de depurar.
Exemple: agent de suport amb reemborsaments a LangGraph
El model classifica i redacta. El codi decideix si la comanda és reemborsable. Una persona aprova el que passi de 100 euros. I un jutge retorna la resposta al redactor si no està a l'alçada:
from typing import Literal, TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver   # en producció, PostgresSaver
from langgraph.types import interrupt, Command

class Tiquet(TypedDict, total=False):
    missatge: str
    intencio: str
    comanda_id: str
    import_: float
    resposta: str
    intents: int

def classificar(s):
    return {"intencio": llm_classificar(s["missatge"])}      # "reemborsament" | "consulta"

def encaminar(s) -> Literal["politica", "respondre"]:
    return "politica" if s["intencio"] == "reemborsament" else "respondre"

def politica(s) -> Command[Literal["aprovacio", "reemborsar", "respondre"]]:
    comanda = crm.buscar_comanda(s["missatge"])              # codi, no LLM
    if not comanda.reemborsable:
        return Command(goto="respondre")
    desti = "aprovacio" if comanda.import_ > 100 else "reemborsar"
    return Command(goto=desti, update={"comanda_id": comanda.id, "import_": comanda.import_})

def aprovacio(s) -> Command[Literal["reemborsar", "respondre"]]:
    ok = interrupt({"accio": "reemborsament", "import": s["import_"]})   # s'atura aquí
    return Command(goto="reemborsar" if ok else "respondre")

def reemborsar(s):
    pagaments.reemborsar(s["comanda_id"], s["import_"], idempotency_key=s["comanda_id"])
    return {}

def respondre(s):
    return {"resposta": llm_redactar(s), "intents": s.get("intents", 0) + 1}

def avaluar(s):
    nota = jutge.puntuar(s["missatge"], s["resposta"])        # LLM com a jutge, de 0 a 1
    return END if nota >= 0.8 or s["intents"] >= 3 else "respondre"

g = StateGraph(Tiquet)
for nom, fn in [("classificar", classificar), ("politica", politica), ("aprovacio", aprovacio),
                ("reemborsar", reemborsar), ("respondre", respondre)]:
    g.add_node(nom, fn)
g.add_edge(START, "classificar")
g.add_conditional_edges("classificar", encaminar)
g.add_edge("reemborsar", "respondre")
g.add_conditional_edges("respondre", avaluar)
graf = g.compile(checkpointer=InMemorySaver())
Tres detalls que separen la demo de la producció, segons la documentació de LangGraph:
- La pausa necessita un checkpointer. Amb un en memòria, el primer redesplegament elimina totes les aprovacions pendents. En producció, una base de dades.
- En reprendre, el node s'executa una altra vegada des del principi. El que hi hagi abans d'
interrupt()s'ha de poder repetir sense conseqüències. - Tot el que mou diners porta clau d'idempotència. Si un pas es repeteix, el reemborsament no.
La factura d'un graf
Els grafs amb diversos agents costen. El sistema de recerca multiagent d'Anthropic va superar en un 90,2% un agent sol, a canvi d'unes 15 vegades més tokens que un xat (Anthropic). En un altre experiment seu, un agent sol va fer una aplicació en 20 minuts per 9 dòlars, però no funcionava. El sistema amb planificador, generador i avaluador va trigar sis hores i va costar 200 dòlars, i funcionava.
La mètrica que importa no és el cost per crida. És el cost per resultat correcte.
Tres productes amb IA, capa a capa
Així s'apliquen les tres capes en tres tipus de producte habituals, amb la mètrica que indica si funcionen.
| Producte | Harness | Loop | Graph | Mètrica d'èxit |
|---|---|---|---|---|
| Assistent de contact center | Només lectura al CRM, eines de comanda i política, traces per conversa | Redactar, avaluar amb un jutge, com a màxim 3 voltes; si no, a un humà | Classificar, encaminar per intenció, signatura humana per sobre del llindar | Casos resolts sense escalar i zero errors de política |
| Extracció de documents (factures, plànols, contractes) | Esquema estricte, validadors aritmètics, l'original sempre a mà | Reintent amb l'error com a pista, detecció de no-progrés, cua humana | Un extractor especialitzat per tipus de document, checkpoint per document | Camps correctes i percentatge que acaba a la cua humana |
| Revisor automàtic de codi | Sandbox de només lectura; cada troballa ha de citar una línia que existeixi | Màxim 25 crides i 10 minuts per revisió | Triatge per risc, revisors de seguretat i qualitat en paral·lel | Precisió i exhaustivitat contra PR antigues amb errors coneguts |
Tots tres comparteixen dues regles. Les decisions amb conseqüències (diners, dades de clients, un merge) no les pren mai el model sol. I tots tenen un conjunt de casos de referència, perquè sense ell no saps si un canvi millora el producte o només el canvia.
Per començar, escriu entre 30 i 50 casos reals amb el resultat esperat. Construeix el harness més senzill que els resolgui. Mesura. I només llavors afegeix un bucle o un graf.
En quina capa està fallant el teu agent?
La recomanació és depurar de baix a dalt. La majoria de fallades que semblen culpa del model són del context o del harness, i canviar de model només canvia el símptoma.
| Si el teu agent… | Mira a | Prova amb |
|---|---|---|
| s'inventa APIs internes o ignora les teves convencions | Context | Un AGENTS.md curt que funcioni com a mapa |
| diu «fet» sense haver comprovat res | Harness | Una verificació obligatòria abans de tancar |
| fa servir l'eina equivocada | Harness | Menys eines i errors que expliquin què cal corregir |
| repeteix el mateix canvi amb variacions mínimes | Loop | Detecció de no-progrés i reinici amb context net |
| aprova els tests perquè els ha canviat | Loop | Rutes protegides i un verificador que no pugui tocar |
| dispara la factura de tokens | Loop | Pressupost de voltes, temps i tokens |
| atén igual de malament peticions molt diferents | Graph | Un node d'encaminament amb branques especialitzades |
| perd el fil després d'una caiguda o una espera | Graph | Checkpoints persistents i nodes idempotents |
| fa alguna cosa irreversible sense permís | Harness i graph | Permisos mínims i una pausa amb aprovació humana |
Abans de posar-lo en producció
- [ ] Tens almenys 30 casos reals amb el resultat esperat.
- [ ] Cada eina té un esquema estricte i errors accionables.
- [ ] Cap acció irreversible depèn només del model.
- [ ] Hi ha un verificador que l'agent no pot modificar.
- [ ] Cada bucle té les seves cinc sortides.
- [ ] El que mou diners o dades porta clau d'idempotència.
- [ ] Cada execució deixa traces que algú pot llegir.
- [ ] Saps quant costa cada resultat correcte, no només cada crida.
Preguntes freqüents
Què és el harness engineering?
El disseny de tot el que envolta el model en un agent d'IA: eines, permisos, context, validacions i traces. Amb el mateix model, un harness millor pot pujar més de 10 punts el resultat en benchmarks públics.
Quina diferència hi ha entre el loop engineering i un agent normal?
Tot agent repeteix crides a eines fins que acaba. El loop engineering dissenya el que hi ha a fora: quan es llança l'agent, com es comprova el que ha fet i, sobretot, quan s'atura.
Quan necessito LangGraph o un altre framework de grafs?
Quan el procés es ramifica, té passos en paral·lel, espera aprovacions humanes o ha de sobreviure a una fallada. Per a una tasca única amb una comprovació clara, un bucle ben acotat és més simple i barat.
Com evito que un agent d'IA entri en un bucle infinit?
Amb cinc sortides: èxit verificat per una màquina, pressupost de voltes i tokens, detecció de no-progrés, escalat a una persona i bloqueig si toca alguna cosa protegida.
És millor un sistema multiagent que un sol agent?
Depèn del cost per resultat correcte. Diversos agents rendeixen més en tasques àmplies i paral·lelitzables, però poden gastar unes 15 vegades més tokens. Per a tasques acotades, un agent amb un bon harness sol ser suficient.
Per on començo a construir un producte amb agents d'IA?
Per 30 a 50 casos reals amb el resultat esperat. Sense ells no pots mesurar si un canvi de prompt, de harness o de model millora el teu producte.
Fonts
- Anthropic, Building effective agents, desembre de 2024.
- Anthropic, Effective harnesses for long-running agents, novembre de 2025.
- Anthropic, How we built our multi-agent research system, juny de 2025.
- Anthropic, Claude Code: /goal i hooks.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world, febrer de 2026.
- B. Böckeler, Harness engineering for coding agent users, martinfowler.com, abril de 2026.
- LangChain, Improving Deep Agents with harness engineering, febrer de 2026.
- LangChain, LangGraph: interrupts.
- Stripe, Minions: Stripe's one-shot, end-to-end coding agents, febrer de 2026.
- G. Huntley, Ralph Wiggum as a «software engineer», juliol de 2025.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, NeurIPS 2024.
- Lee et al., Meta-Harness, arXiv, març de 2026.
- Lulla et al., Loop Engineering: Building Blocks, Adoption, and Impact, arXiv, agost de 2026.
- Feng et al., Graph Engineering in the Era of LLM Agents, arXiv, agost de 2026.